- 임베딩 기반의 대규모 분류/유사도 학습 시 사용되는 트릭으로 현재 mini-batch 안의 다른 item들을 negative로 재활용
- 별도 negative 샘플링 과정이 불필요하고 메모리 절약, 설정에 따라 hard negative 역할도 가능
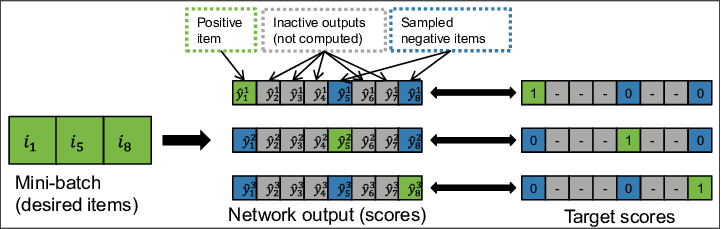
- 각 row는 하나의 쿼리(혹은 user), 각 column은 item을 의미
- desired items(초록색): 이번 mini-batch에 포함된 positive item들
- sampled negative items(파란색): 해당 쿼리와 상호작용하지 않은 다른 아이템들 중 샘플링된 negative item들
- 위 그림에서는 다른 쿼리의 positive만 negative로 샘플링하고 있음 -> hard negatives
선택 편향 (Selection Bias)
BNS의 핵심 문제: 인기 아이템이 미니배치에 더 자주 등장 → 아이템 선택 확률이 Unigram 분포를 따름
- 인기 아이템이 negative로 과도하게 처리됨 → 롱테일 아이템과의 구분 능력 약화
- NLP 유비: Zipf 법칙처럼 인기 아이템의 빈도가 순위에 반비례해 집중됨
logQ 보정 (Yi et al., 2019)
점수에서 샘플링 확률의 로그를 빼 편향을 보정:
여기서 (아이템 의 Unigram 확률)
인기 아이템일수록 값이 커서 점수가 낮아지고, 롱테일 아이템은 상대적으로 점수가 올라가 편향이 완화된다.
요청 정렬 데이터에서의 거짓 음성 (False Negative)
학습 데이터를 Request-level Deduplication 목적으로 요청(request) 단위로 정렬하면 IID 가정이 깨지면서 거짓 음성이 급증한다.
- IID 배치: 거짓 음성 ~0% (서로 다른 사용자의 아이템이 섞임)
- 요청 정렬 배치: 같은 배치 안에 동일 사용자의 다른 아이템들이 집중 → 실제로는 positive일 가능성이 높은 항목이 negative로 취급됨 → 거짓 음성 ~30%
해결책: user-level masking — 동일 사용자(요청)에서 온 아이템은 negative 후보에서 제외하고, 다른 사용자의 아이템만 negative로 사용. logQ 보정(logQ 보정)은 별도로 유지.