TL;DR
검색과 추천을 한 앱에서 제공하는 서비스에서, 유저가 두 scenario 사이를 오가는 전이(s2s, r2r, r2s, s2r)를 추출-정렬-융합 3단계로 fine-grained하게 모델링해 검색·추천 성능을 동시에 끌어올린 통합 프레임워크
Background
- 많은 플랫폼에서 검색(S)과 추천(R)을 한 앱에서 함께 제공하면서 유저 행동이 두 scenario의 경계를 넘나들게 됨
- 추천 보던 중 궁금한 걸 검색하거나(r2s), 검색 후 관련 아이템을 계속 둘러보는(s2r) 식의 transition(전이)가 빈번
- 기존 접근의 한계
- JSR: 두 모델이 아이템 표현을 공유하며 joint loss로만 학습 → 전이 자체를 구분하지 않음
- SESRec, UnifiedSSR: S/R 히스토리를 별도 인코더에 넣어 s2s, r2r만 암묵적으로 모델링 → scenario를 가로지르는 r2s, s2r 전이는 반영하지 못함
- USER: S&R 히스토리를 타임스탬프 순으로 섞어 단일 인코더에 넣음 → 모든 전이를 같은 방식으로 뭉뚱그려 처리, fine-grained한 구분이 없음
- -> 즉 “전이를 명시적으로, 그리고 종류별로 다르게” 다루는 메커니즘이 없다는 게 공통적인 공백
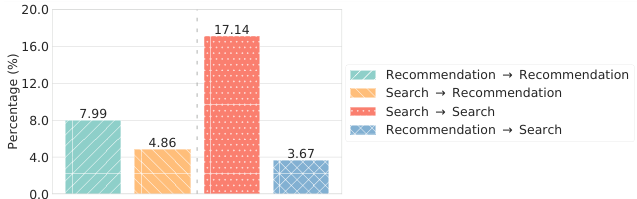
- 추천/검색 간 전이가 실제로 정보 니즈 변화를 의미하는가?를 KuaiSAR (역시 Kwai 앱 데이터의 검색+추천 로그를 데이터셋으로 공개한 이전 논문)로 검증
- 직전 클릭 아이템과 현재 아이템이 같은 카테고리인 비율을 직전 scenario별로 측정
- 추천 상황: 직전이 추천(R→R)이면 상관 7.99%, 직전이 검색(S→R)이면 4.86%로 하락
- 검색 상황: 직전이 검색(S→S)이면 17.14%, 직전이 추천(R→S)이면 3.67%로 급락
- -> scenario가 바뀌는 시점에는 새로운 정보 니즈가 생겼을 가능성이 훨씬 높다는 뜻이고, 이는 전이를 fine-grained하게 모델링해야 할 근거가 됨
Method
Problem Formulation
- 유저 히스토리 는 시간순으로 정렬된 S&R 행동 시퀀스
- 이면 추천 아이템 , 이면 검색 (쿼리와 그 쿼리로 클릭한 아이템 집합)
- 공개 데이터셋을 로 묶어 추천용 라벨 과 검색용 라벨 를 동시에 예측하는 단일 함수 를 학습하는 것이 목표
- -> 모델 하나로 두 태스크를 함께 서빙한다는 것이 핵심 설계 목표
Embedding Module
- 유저/아이템/쿼리 단어에 대한 임베딩 테이블을 두고, 검색 behavior는 쿼리 임베딩(단어 mean pooling) + 클릭된 아이템들의 mean pooling으로 구성
- (추천) 또는 (검색)
- Query-Item Contrastive Learning ()
- 검색엔 쿼리가 있고 추천엔 없어서, 두 scenario를 그냥 섞으면 모델이 전이를 포착하기 어렵다
- 쿼리 와 그 쿼리로 클릭된 아이템을 positive, 랜덤 샘플링한 다른 쿼리/아이템을 negative로 삼아 contrastive loss를 걸어 쿼리와 아이템을 같은 표현 공간에 정렬
- -> 이 정렬이 검색 성능(쿼리-아이템 relevance)의 기반이자, 이후 S&R 전이를 연결하는 다리 역할
Transition Modeling
전이 모델링을 extraction → alignment → fusion 3단계로 분해
1) Transition Extraction
- s2s, r2r: 검색 서브히스토리 , 추천 서브히스토리 을 각각 별도의 Transformer encoder(, )에 self-attention으로 통과시켜 , 을 얻음
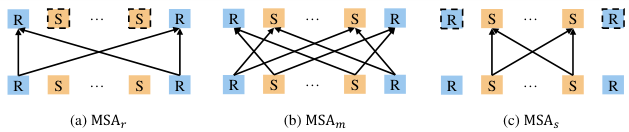
- r2s, s2r: 전체 믹스 시퀀스 를 그냥 하나의 transformer에 넣으면 출력에 s2s, r2r 정보까지 섞여 , 과 redundant해진다
-
이를 막기 위해 mask matrix 을 도입: (같은 scenario), (다른 scenario)
-
로 서로 다른 behavior 간 attention만 계산되도록 강제
-
-> mask 하나로 “같은 transformer 안에서 cross-scenario 전이만 뽑아내는” 간단하지만 효과적인 트릭
-
결과 에서 검색/추천 서브시퀀스를 각각 분리해 , 획득
-
, , 세 모듈이 각각 어떤 토큰 쌍 사이에 attention을 계산하는지 보여주는 다이어그램
-
/는 같은 scenario 내부끼리만, 은 R-S 사이에서만 attention이 연결됨 → mask가 세 종류의 attention 패턴을 명확히 분리한다는 것을 시각적으로 확인시켜줌
-
2) Transition Alignment
- 같은 서브히스토리 맥락에서 나온 두 전이를 서로 positive로 삼아 contrastive learning으로 정렬
- 와 는 둘 다 검색 히스토리 맥락에서 나온 표현이므로 mean pooling 후 정렬 ()
- 마찬가지로 와 정렬 ()
- -> 왜 필요한가: 서로 다른 transformer에서 독립적으로 뽑힌 전이 표현들을 미리 같은 의미 공간으로 당겨 놓아야, 다음 단계의 cross-attention fusion이 제대로 작동한다 (Align before Fuse 아이디어를 S&R 도메인에 적용한 셈)
3) Transition Fusion
- Multi-head Cross-Attention(MCA)으로 전이들을 최종 융합
- 검색 표현: ,
- 추천 표현: ,
- 즉 “같은 scenario 전이”를 K/V로, “다른 scenario에서 온 전이”를 Q로 사용해 cross-scenario 신호를 같은 scenario 표현에 녹여 넣는 구조
Prediction & Training
- History Aggregation: target item 와의 유사도 기반 attention으로 , 을 각각 , 로 집약
- MMoE로 멀티태스크 예측: 을 shared/specific experts에 통과시켜 , 두 스코어를 산출
- -> S&R 데이터 분포 차이로 인한 seesaw 현상(한쪽이 좋아지면 다른쪽이 나빠짐)을 완화하기 위한 장치
- Loss: BCE click loss(, ) + + 을 각 태스크 loss에 더하고, 전체는
- 가 S/R 간 균형을 조절하는 핵심 하이퍼파라미터
Experiments
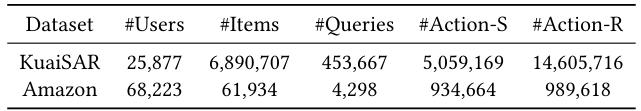
- KuaiSAR(실제 S&R 로그, 유저 25,877 / 아이템 690만 / 쿼리 45만 / Action-S 506만 / Action-R 1,461만)와 Amazon Kindle Store(semi-synthetic, 유저 6.8만 / 아이템 6.2만) 두 데이터셋의 통계
- KuaiSAR는 추천 행동(Action-R)이 검색 행동(Action-S)보다 3배 가까이 많아 극단적으로 sparse한 검색 데이터를 가짐 → 뒤에서 joint training의 효과를 해석하는 핵심 배경이 됨
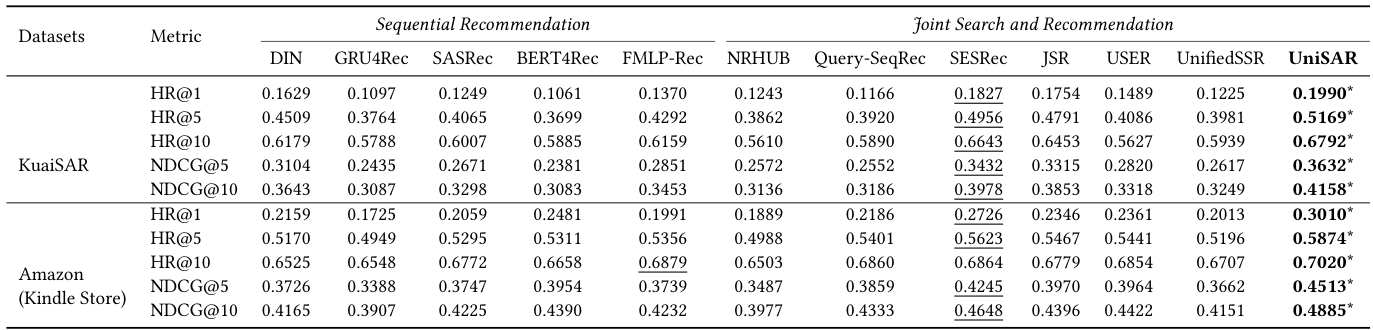
- Sequential recommendation 계열(DIN, GRU4Rec, SASRec, BERT4Rec, FMLP-Rec)과 Joint S&R 계열(NRHUB, Query-SeqRec, SESRec, JSR, USER, UnifiedSSR)을 포함한 추천 성능 비교
- KuaiSAR NDCG@5: UniSAR 0.3632로 2위 SESRec 0.3432 대비 +5.8%, HR@1은 2위 JSR 0.1754 대비 +13.5%
- Amazon NDCG@5: UniSAR 0.4513으로 2위 SESRec 0.4245 대비 +6.3%
- 모든 지표에서 유의미한 개선, 단순 S&R 블렌딩 모델(NRHUB, Query-SeqRec)이 오히려 단일 scenario 모델보다 떨어지는 경우가 있어 “그냥 합치는 것”만으론 부족하다는 논지를 뒷받침
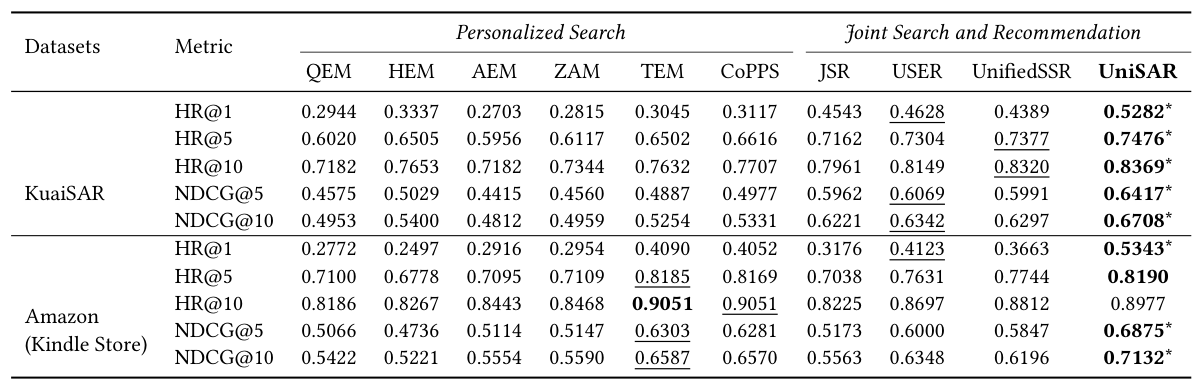
- Personalized search 계열(QEM, HEM, AEM, ZAM, TEM, CoPPS)과 Joint S&R 계열을 포함한 검색 성능 비교
- KuaiSAR NDCG@5: UniSAR 0.6417로 2위 USER 0.6069 대비 +5.7%, 격차가 추천보다 더 크게 벌어짐
- -> KuaiSAR는 검색 데이터가 매우 sparse하기 때문에(Table 2), joint training으로 추천 정보를 끌어와 검색 성능을 크게 보강한 결과로 해석됨
Ablation Study (KuaiSAR)
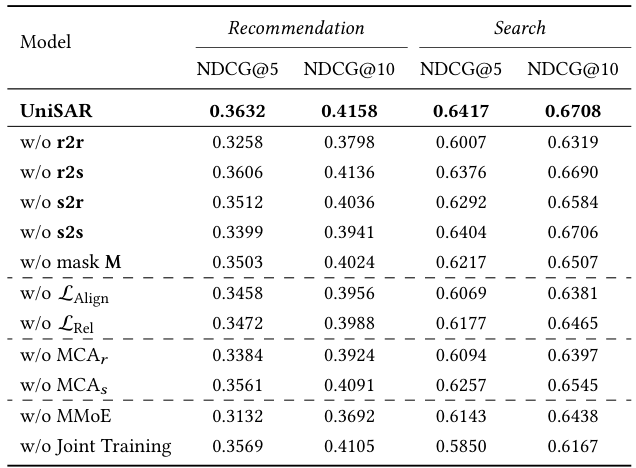
- 4가지 전이, mask M, , , cross-attention, MMoE/joint training을 각각 제거한 variant들의 NDCG 비교
- 전이 제거: 네 전이 모두 제거 시 성능 하락, 특히 r2r 제거가 추천(NDCG@5 0.3632→0.3258)에, s2r 제거도 추천(→0.3512)에 큰 타격 → 각 전이가 독립적으로 유의미한 정보를 담고 있음을 확인
- mask M 제거(믹스 시퀀스를 그냥 하나의 transformer에): NDCG@5 추천 0.3503, 검색 0.6217로 하락 → cross-scenario 전이를 분리 추출하는 설계의 효과를 입증
- , 제거: 둘 다 하락(특히 검색에서 0.6417→0.6069/0.6177) → contrastive 정렬이 전이 간 관계 학습과 쿼리-아이템 relevance 학습에 실질적으로 기여
- MCA를 단순 element-wise 덧셈으로 대체: 하락 → cross-attention 기반 fusion이 단순 결합보다 유리
- MMoE 제거: 추천 NDCG@5 0.3132로 가장 크게 하락. Joint training 자체를 제거(별도 파라미터 학습)하면 검색이 0.5850으로 급락
- -> MMoE 유무에 따라 seesaw 양상이 다르게 나타남: MMoE 없이 joint training만 하면 검색은 오르고 추천은 크게 떨어짐, 반면 완전 분리 학습은 반대로 검색이 크게 떨어짐 → MMoE가 이 trade-off를 조절하는 핵심 장치
Experimental Analysis
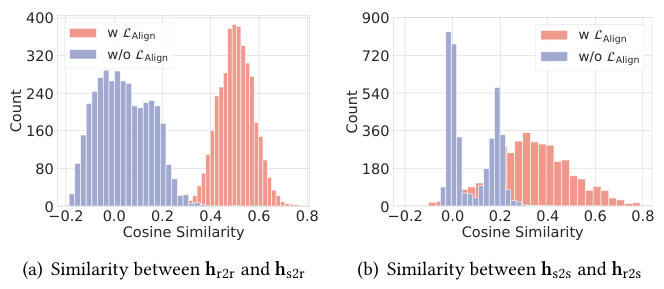
- 유무에 따라 -, - 쌍의 cosine similarity 분포를 히스토그램으로 비교
- 없이는 유사도가 0 근처에 몰려 전이 간 상관이 거의 없음을 보여주고, 적용 후에는 분포가 뚜렷하게 양의 방향으로 이동 → alignment loss가 실제로 전이 표현 간 관계를 학습시킨다는 직접적인 증거
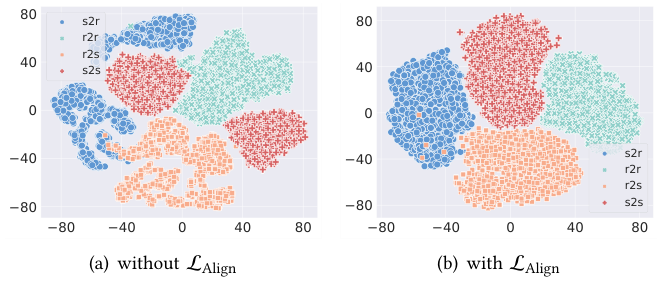
- t-SNE로 4가지 전이(s2r, r2r, r2s, s2s) 표현을 2차원에 시각화
- 없을 때는 전이들이 흩어져 있고 특히 s2r, s2s가 군집을 이루지 못함. 적용 후에는 군집이 뚜렷해지고, 같은 transformer에서 파생된 s2r과 r2r(둘 다 recommendation 관련 전이)이 더 가까워짐 → alignment가 fusion에 적합한 표현 공간을 만들어 준다는 것을 시각적으로 뒷받침
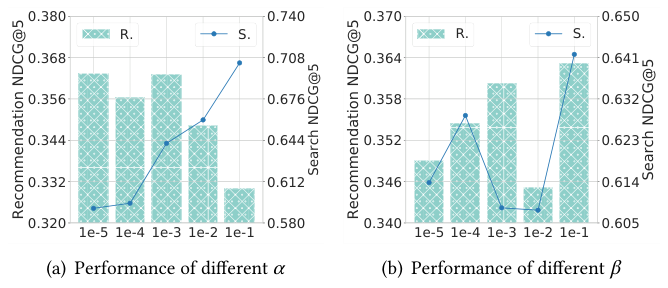
- ( 가중치), ( 가중치)를 바꿔가며 S&R 성능을 측정
- 가 커질수록 검색은 좋아지고 추천은 나빠지는 trade-off가 뚜렷함 → 이 쿼리-아이템 relevance를 강화해 검색에 직접적으로 기여하지만, 과도하면 click loss 최적화를 방해해 추천이 손해를 봄
- 는 1e-1에서 S&R 모두 최적 → 너무 작으면 전이 간 유사도를 충분히 학습하지 못해 fusion 품질이 떨어짐
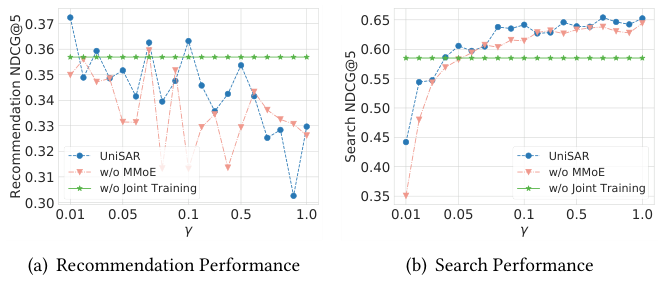
- 값을 바꿔가며 UniSAR / w/o MMoE / w/o Joint Training 세 가지의 S&R 성능을 비교
- MMoE 없이 를 올리면 검색은 개선되지만 추천은 분리 학습 모델보다도 낮아지는 뚜렷한 seesaw가 나타남
- MMoE를 도입하면 대부분의 구간에서 분리 학습 모델보다 더 나은 성능을 동시에 달성 → MMoE가 S&R 공유/특화 정보를 적절히 분배해 seesaw를 완화한다는 것을 정량적으로 보여줌