Source
PP-Rec: News Recommendation with Personalized User Interest and Time-aware News Popularity (2021)
TL;DR
personalization 점수와 time-aware popularity 점수를 결합해 랭킹함으로써 콜드스타트와 다양성 문제를 동시에 완화한 뉴스 추천 모델
Background
- 기존 개인화 뉴스 추천의 두 가지 구조적 한계(콜드스타트, 다양성 부족)를 뉴스 인기도를 보조 신호로 씀으로써 해소하자
- 기존 방법(NRMS, LSTUR 등)은 클릭 이력 → 유저 임베딩 → 뉴스 임베딩과의 매칭으로 랭킹하는 구조
- 콜드스타트 유저는 클릭이 희소해 관심사를 정확히 모델링하기 어려움
- 유저가 이미 읽은 것과 비슷한 뉴스만 추천되는 필터버블 경향
- 저자들의 관찰: 인기 뉴스는 (1) 중요한 정보(재난, 선거 등)를 담고 있어 개인 관심사와 무관하게 많은 유저를 끌어들이고, (2) 주제가 다양함
- -> 인기도를 결합하면 콜드스타트와 다양성 문제를 동시에 완화할 잠재력이 있다는 것이 핵심 motivation
- -> 즉 인기도 신호는 “관심사가 불명확한 유저”에게도 믿을 수 있는 fallback이자, 추천 목록에 다양성을 주입하는 역할을 겸함
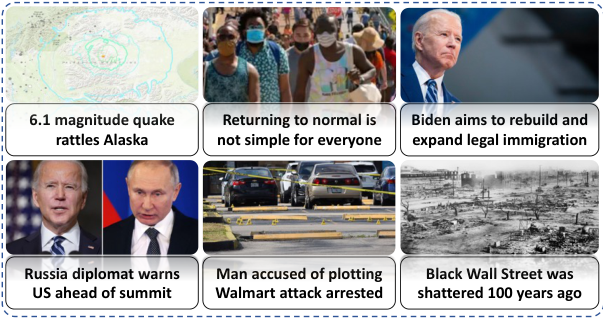
- 모두 특정 개인 취향과 무관하게 많은 사람이 클릭할 만한 보편적 중요도를 가진 뉴스라는 점을 보여줌 → “인기 뉴스 = 다양한 유저를 커버하는 콘텐츠”라는 motivation의 직관적 근거
- 기존 인기도 기반 추천(ViewNum, SCENE 등)은 조회수/댓글수를 쓰는데, 뉴스마다 impression 기회 차이가 커서 편향(impression bias)이 생김 -> CTR을 사용
Method
전체 구조
- 핵심 요약: 랭킹 점수를 “개인화 매칭 점수”와 “뉴스 인기도 점수” 두 축으로 분리하고, personalized aggregator로 유저별 가중치를 학습해 결합
- ranking score 는 personalized matching score (뉴스 콘텐츠 임베딩과 유저 임베딩의 dot product)과 news popularity score (콘텐츠, 최신성, 실시간 CTR 기반)의 결합
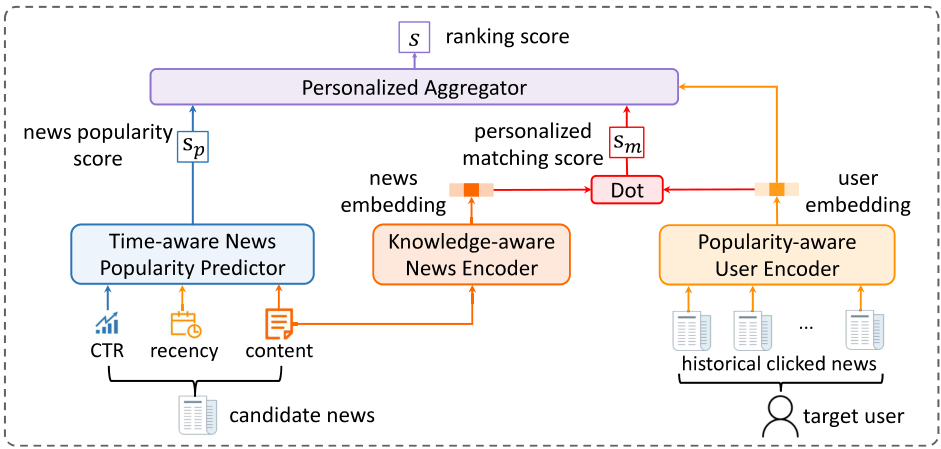
- 인기도 예측과 개인화 매칭이 독립된 두 경로로 계산된 뒤 최종 단계에서만 결합되는 구조 → 두 신호가 서로 다른 정보원(콘텐츠/행동 vs CTR/최신성)에서 나온다는 것을 보여줌
Knowledge-aware News Encoder
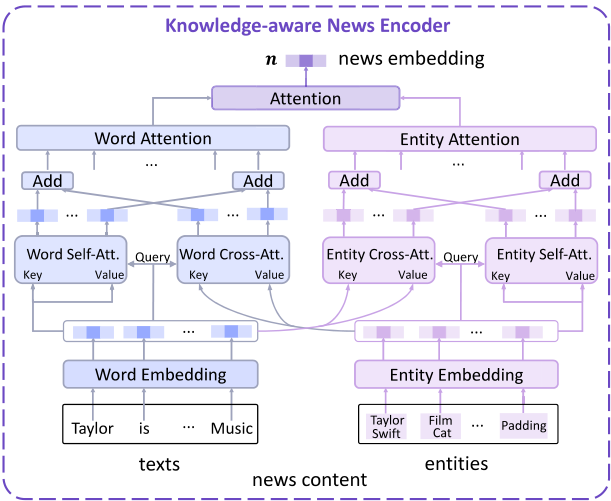
- 요약: 뉴스 제목의 단어뿐 아니라 엔티티(지식 그래프) 정보까지 결합해 더 풍부한 뉴스 콘텐츠 임베딩을 만들기 위함
- 단어 임베딩(Glove)과 엔티티 임베딩(TransE, WikiData)을 각각 준비
- 엔티티끼리의 연관성을 포착하는 self-attention(MHSA)과, 텍스트 문맥으로부터 엔티티 의미를 보정하는 cross-attention(MHCA)을 병렬로 적용 후 합산
- -> 예: “MAC”이라는 엔티티는 “Lancome”과 같이 나오면 화장품, “Apple”과 같이 나오면 컴퓨터를 의미 → 엔티티 자체만으론 모호하므로 텍스트 문맥(MHCA)이 필요하다는 논리
- 단어도 동일하게 MHSA(단어 간 관계) + MHCA(단어-엔티티 관계)로 표현 학습
- entity attention / word attention으로 각각 뉴스 표현 , 를 만들고, 다시 attention으로 와 를 가중합해 최종 뉴스 표현 생성
Time-aware News Popularity Predictor
- 동기: CTR은 믿을 만한 인기도 신호지만, 막 게시된 뉴스는 아직 충분한 노출/클릭이 쌓이지 않아 부정확함 → 콘텐츠 기반 예측으로 보완해야 함
- content-based popularity : 뉴스 콘텐츠 임베딩 에 dense network 적용
- recency-aware popularity : 발행 후 경과 시간(시간 단위)을 임베딩해 dense network에 통과
- -> 뉴스마다 인기 수명(lifecycle)이 다르다는 전제하에, 콘텐츠 기반 예측과 최신성 기반 예측을 게이트로 혼합
- content-specific aggregator:
- 는 뉴스 콘텐츠와 recency 임베딩을 보고 계산되는 게이트 → 뉴스 종류에 따라 콘텐츠 비중과 최신성 비중을 동적으로 조절 (속보성 뉴스는 recency 비중이, 오래가는 주제는 콘텐츠 비중이 커지도록 학습될 것으로 추정)
- 최종 인기도 점수:
- $c_t$는 최근 $t$시간(실험에서는 1시간) 동안의 실시간 CTR, $\hat p$는 콘텐츠+최신성 기반 예측치 → 둘을 학습 가능한 가중치로 선형 결합해, 데이터가 충분히 쌓인 뉴스는 CTR에, 신규 뉴스는 콘텐츠/최신성 예측에 더 의존하도록 만듦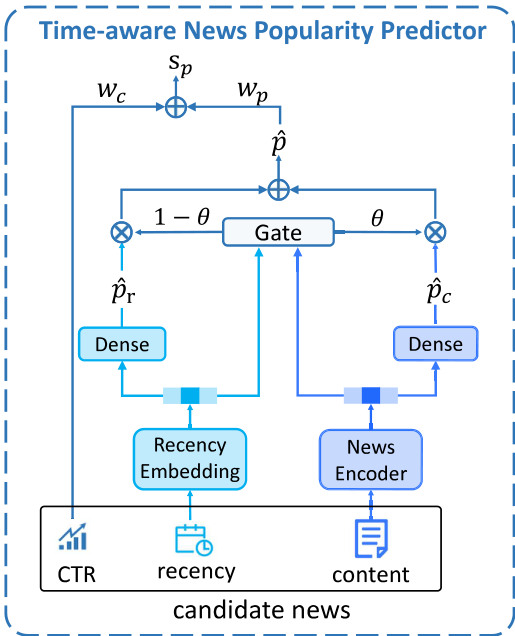
- 인기도 예측이 단일 신호가 아니라 세 신호의 조건부 결합 - ablation에서 셋 다 유효함을 검증
Popularity-aware User Encoder
- 유저의 클릭 이력에는 “진짜 관심사”뿐 아니라 “그냥 인기 뉴스라서 클릭한” 행동이 섞여 있어, 이 인기도 편향을 제거해야 유저 관심사를 더 정확히 추출할 수 있음
- -> 예: “Justin Timberlake 신곡” 클릭은 진짜 관심사 신호, “트럼프 탄핵” 클릭은 그냥 핫이슈라서 클릭한 신호일 수 있음 → 후자를 유저 interest로 과대평가하면 안 됨
- 클릭 뉴스 표현에 news self-attention을 적용해 클릭 뉴스 간 관계를 반영한 contextual representation 생성
- 각 클릭 뉴스의 인기도(앞서 예측한 , 단 미분 불가능한 quantization을 피하기 위해 recency/content는 제외하고 재계산)를 양자화해 popularity embedding 로 변환
- content-popularity joint attention (CPJA): 콘텐츠와 인기도를 함께 보고 attention weight 계산
- 인기도가 높아서 클릭했을 가능성이 큰 뉴스는 attention weight가 낮아지도록 학습되어, 유저 임베딩 에 덜 반영됨 → popularity bias 제거
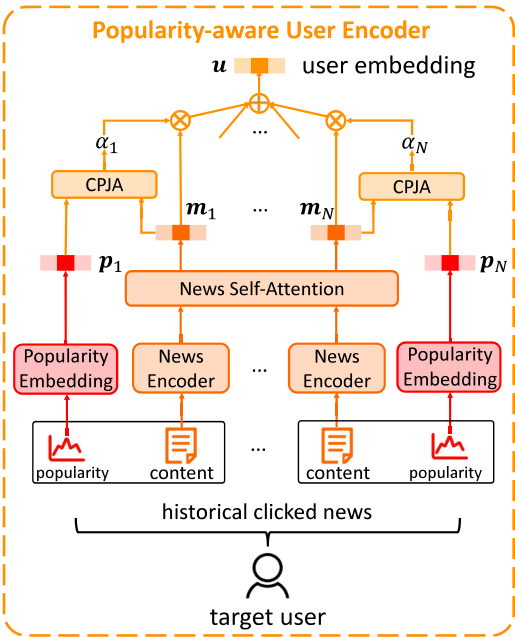
- 인기도 임베딩이 attention weight 계산에만 관여하고 최종 의 값 자체에는 직접 더해지지 않는다는 점이 핵심 (인기도는 “걸러내는 신호”로만 쓰임)
News Ranking and Model Training
- 두 점수의 상대적 중요도가 유저마다 다르다는 것을 반영하기 위해 personalized aggregator로 유저별 가중치 를 학습
- 는 유저 임베딩 로부터 계산되는 게이트 → 콜드스타트 유저는 (행동 기반 매칭)이 부정확하므로 (인기도 비중)가 커지도록 학습될 것이라는 가설이 핵심 설계 의도
- BPR pairwise loss로 학습, 같은 impression 내에서 negative sampling
Experiments
- 핵심 요약: 기존 뉴스 추천 데이터셋에는 인기도 정보가 없어 저자들이 직접 2개의 데이터셋(MSN, Feeds)을 구축해 정확도와 다양성을 동시에 검증
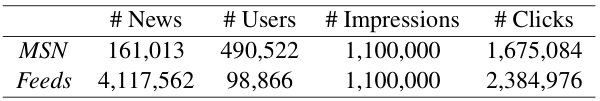
- MSN(161K 뉴스, 49만 유저, 110만 impression) / Feeds(412만 뉴스, 9.9만 유저, 110만 impression) 두 데이터셋 통계
- Feeds는 뉴스 수가 훨씬 많지만 유저 수는 더 적음 → 포털형(MSN)과 피드형(Feeds) 두 성격이 다른 플랫폼에서 일관된 효과를 보이는지 검증하려는 의도로 보임
전체 성능
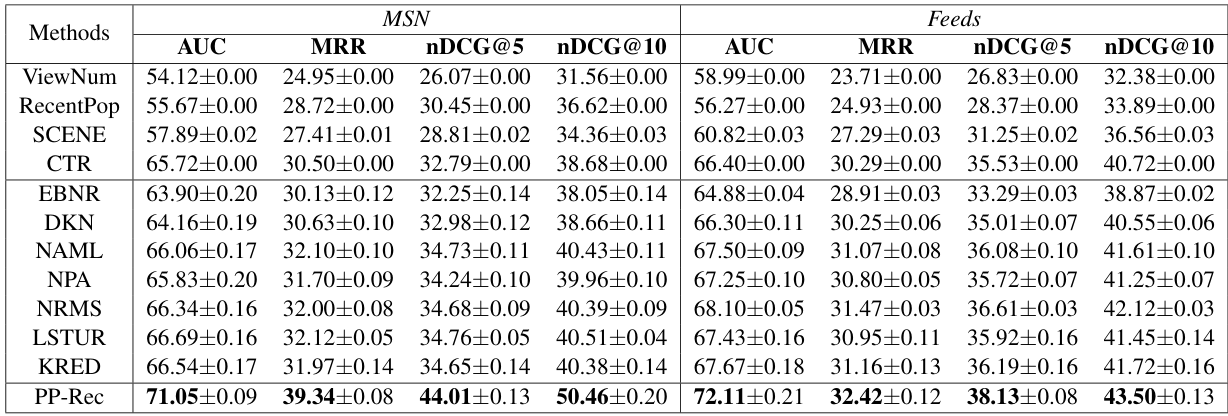
- AUC/MRR/nDCG@5/nDCG@10 기준 popularity 계열(ViewNum, RecentPop, SCENE, CTR) 4개 + personalized 계열(EBNR, DKN, NAML, NPA, NRMS, LSTUR, KRED) 7개와 비교
- PP-Rec이 MSN에서 AUC 71.05(2위 LSTUR 66.69 대비 +4.36%p), Feeds에서 72.11(2위 NRMS 68.10 대비 +4.01%p)로 전 지표 최고 성능, p<0.001로 유의
- -> popularity 계열 중 CTR이 ViewNum보다 나은 것(MSN 기준 65.72 vs 54.12)도 “impression bias 제거” 가설을 뒷받침하는 결과
콜드스타트 성능
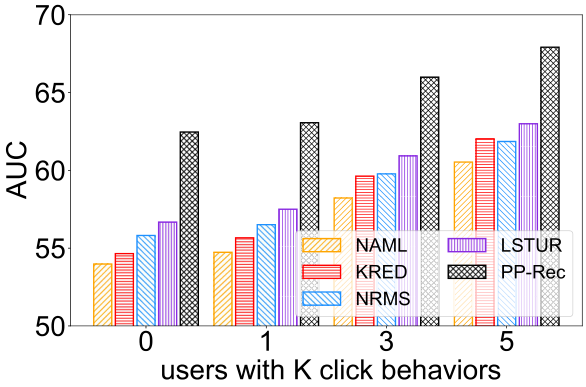
- 클릭 이력 개인 유저 그룹별 AUC 비교 (NAML, KRED, LSTUR, NRMS vs PP-Rec)
- (클릭 이력 전무)에서도 PP-Rec이 가장 큰 격차로 우위 → 행동 기반 신호가 전혀 없어도 인기도 신호만으로 상당한 추천 품질을 낼 수 있다는 것을 보여줌 (콜드스타트의 fallback으로 인기도가 실제로 작동)
다양성
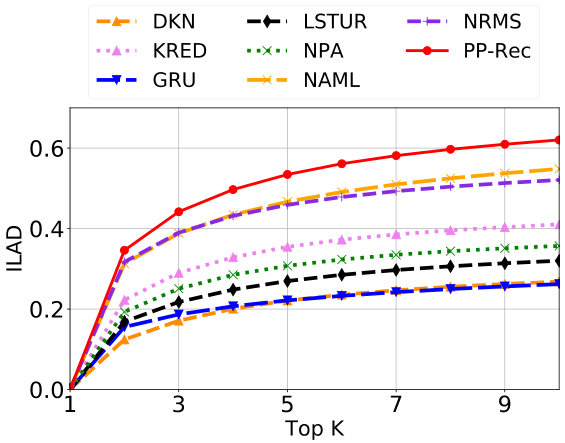
- Top-K 추천 리스트 내 뉴스 표현 간 평균 거리(ILAD, intra-list average distance)를 ~에 대해 측정
- PP-Rec이 전 구간에서 가장 높은 ILAD → 추천 리스트 내부가 더 이질적인 뉴스로 구성됨을 의미
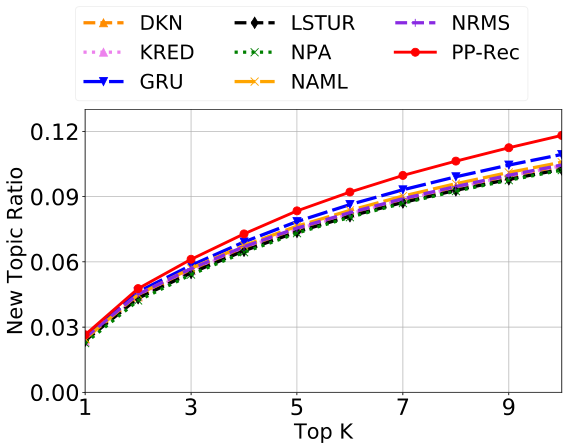
- 유저의 과거 클릭 주제에 없던 새 주제의 비율(new topic ratio)을 ~에 대해 측정
- PP-Rec이 가장 높음 → 유저가 기존에 안 읽어본 주제를 더 많이 추천 = 필터버블 완화와 직결되는 지표
Ablation Study
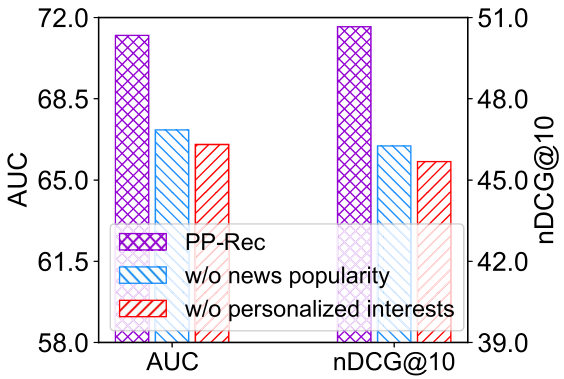
- PP-Rec에서 news popularity score() 또는 personalized matching score()를 각각 제거했을 때 AUC/nDCG@10 변화
- 둘 다 제거 시 성능 하락 → 두 점수가 상호보완적이며 어느 하나만으로는 전체 성능을 못 낸다는 것을 확인
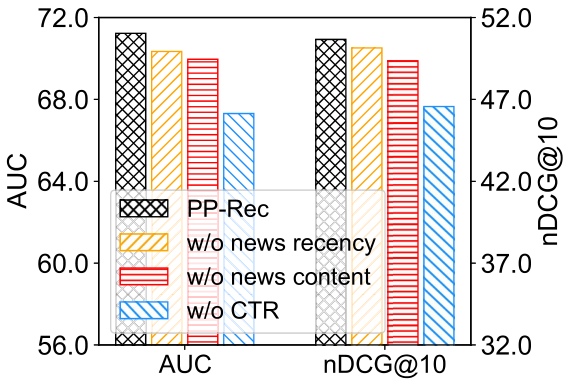
- 인기도 예측기에서 recency / content / CTR을 각각 제거했을 때 AUC/nDCG@10 변화
- CTR 제거 시 하락폭이 가장 커 가장 중요한 신호임을 시사, content 제거 시에도 하락(신규 기사 커버를 위해 필요), recency 제거도 하락(인기도의 시간 감쇠를 못 잡음)
- -> 세 신호가 서로 다른 실패 모드(콜드 아이템, 동적 변화)를 커버하는 보완재임을 보여줌
Case Study
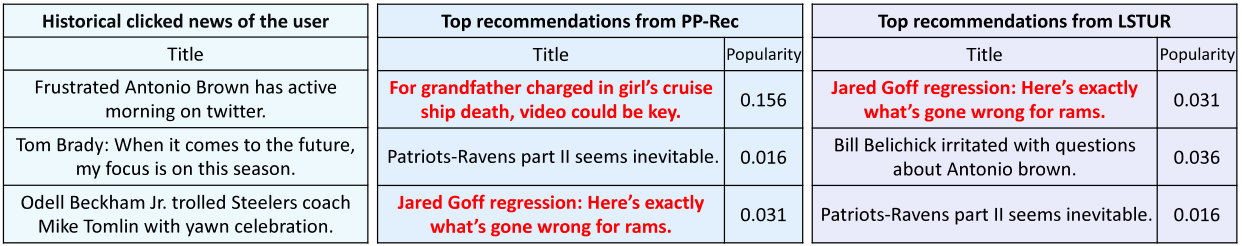
- 특정 유저 1명에 대해 PP-Rec과 LSTUR의 top-3 추천과 실제 클릭 결과 비교 (빨간 볼드 = 실제 클릭)
- 유저가 과거 풋볼 뉴스를 3번 클릭한 이력이 있어 둘 다 풋볼 뉴스를 추천해 맞췄지만, PP-Rec만 “범죄 사건” 뉴스(유저의 과거 관심사와는 무관하지만 예측 인기도가 높은 뉴스, 0.156)를 추천해 실제 클릭을 맞춤
- -> 행동 기반으로는 포착 불가능한 관심사를 인기도가 보완하는 구체적 사례