유저의 1.5년치 청취 로그를 4채널(volume, repetition, organicity, liked) 주간 시계열로 인코딩하고, dictionary learning으로 해석 가능한 32개 atom을 학습해 그 투영 계수를 유저 임베딩으로 쓰는 프레임워크
- weekly 단위로 반복되는 activity-driven listening을 설명하기 위한 압축된 단일 유저 임베딩으로 기능
- 근데 단일 임베딩이기에 이 유저가 “어떤 상황에서 음악을 듣는 사람인지”를 표현할 뿐 이 임베딩이 실제 추천 시스템에서 context-aware한 추천에 어떤 식으로 통합되어야 하는지는 커버하지 않음.
Background
- 문제 정의: 음악 스트리밍의 listening context 연구는 시간, 기기, 위치, 날씨 등 observable한 context 변수를 중심으로 진행됨
- 이런 접근들은 유저 히스토리를 짧은 기간의 snapshot으로만 다루고(각 세션마다 임베딩이 형성되는 식 - 월요일 아침 출근할 때 듣는 세션 딱 그 순간), time window도 비교적 coarse하게 잡아 유저의 전체적인 시간적 행동 프로필을 만들지 못한다는 한계
- -> 즉 “어떤 순간에 어떤 context였나”는 포착해도, “이 유저가 매주 반복적으로 이 시간대에 듣는다”는 규칙성 자체는 놓친다는 지적.
- 핵심 개념: soundtracking (활동을 동반하는 청취). e.g. 집중해서 공부할 때 lofi를 듣는 것처럼, 활동에 따라 평소 취향과 다른 음악을 선택하는 현상.
- soundtracking은 특정 활동과 강하게 결부되어 있고, 사람들은 요일/시간대별로 반복되는 생활 패턴(평일=업무, 주말=여가)을 따르는 경향이 있음
- 연구 질문: 유저 로그의 패턴(규칙성)을 이용해 activity-driven listening을 특징지을 수 있는가?
- 기존 활동 예측 연구는 주로 트랙 자체에 활동 태그를 다는 content-tagging 방식인데, 저자들은 트랙-활동 매핑이 유저마다 다르다고 보고(예: 기상 음악으로 누군가는 잔잔한 곡, 누군가는 에너제틱한 곡을 선호) 유저 모델링 기반 접근을 택함
Method
3.1 Encoding Consumption Histories
-
왜 필요한가: 반복 패턴을 포착하려면 먼저 원시 로그(타임스탬프, 곡 ID, 스트림 origin 등)를 구조화된 시계열로 바꿔야 함
- 연 단위/주 단위가 비즈니스 시계열에서 가장 중요한 계절성이라는 선행 연구에 따라, 데이터 길이(1.5년, 2022.01~2023.05)를 고려해 weekly 주기에 집중
-
1시간 윈도우 단위로 스트림을 집계하고, 주 단위(168시간, 7일×24시간)로 다시 평균해 “매주 화요일 오전 10~11시” 같은 고정 슬롯에 값을 할당한다.
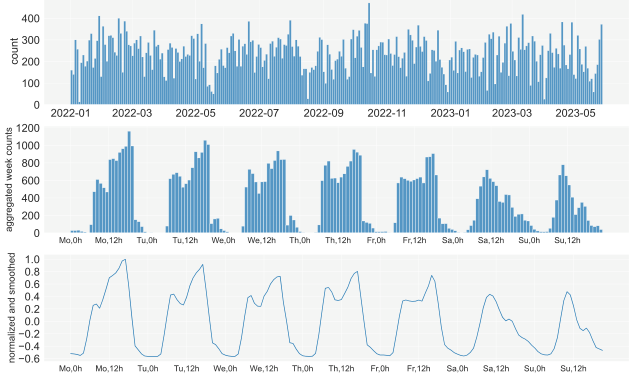
- 한 유저의 원시 스트림 카운트(상단) → 주간 스케일 집계(중단) → convolution+정규화 후(하단)의 변환 과정
- 전체 기간 로그에서는 보이지 않던 주간 반복 패턴이, 주 단위로 접어서(aggregation) 평균을 내면 뚜렷한 사인 곡선 형태로 드러난다
-
4개 채널로 유저 행동의 서로 다른 측면을 인코딩
- Volume: 단순 스트림 수. 전반적인 청취 활동량과 규칙적 청취 시간대를 포착.
- Repetition: 3회 이상 들은 곡의 비율. 반복 청취는 Mere Exposure Effect 선행연구에 따라 “새로운 발견” 의도보다 “감정 영향 통제” 의도를 나타낸다고 해석.
- Organicity: organic(유저가 직접 선택) vs 알고리즘 추천 스트림의 비율 (전체의 약 80%가 organic). 유저가 콘텐츠 선택에 얼마나 주도권을 갖는지를 나타내는 지표.
- Liked: 좋아요한 곡/앨범의 스트림 비율. “지금 듣는 음악이 평소 취향에 얼마나 부합하는가”를 근사.
- -> 4개 모두 “어떻게/얼마나 듣는가”의 정보이고 “무엇을” 듣는가의 정보는 아님. 사실 장르 정도만 넣어도 제일 핵심적으로 기능했을 것 같은데 왜 이렇게 한 건지 명확한 설명은 없음
-
수식:
- 는 유저, 는 채널, 는 주간 1시간 슬롯. 는 전체 기간 중 같은 주간 슬롯 에 해당하는 모든 1시간 구간. 는 각 채널의 집계 함수(volume은 카운트, 나머지는 비율).
- -> 즉 “매주 같은 슬롯”에 해당하는 값들을 전체 기간에 걸쳐 평균 내는 것. 30초 미만 스트림은 제외.
-
후처리: 1시간 경계를 부드럽게 하기 위해 길이 3짜리 constant filter로 convolution 적용, 이후 채널별로 평균 0 / 최대 절대값 1이 되도록 정규화.
- 정규화를 하는 이유는 다음 dictionary learning 단계가 “패턴의 형태”에 집중하도록 하고, 유저 간 절대적 청취량 차이가 atom 학습을 지배하지 않게 하기 위함.
3.2 Detecting Listening Behavior Patterns
- 왜 필요한가: 4채널 x 168시간의 raw 시계열은 그대로 쓰기엔 차원이 크고 노이즈가 많다. 소수의 “전형적 패턴(atom)“으로 압축해야 해석 가능하면서도 재사용 가능한 임베딩을 만들 수 있다.
- Dictionary learning을 사용하되, 멀티채널 시계열이므로 multivariate dictionary learning 구현(원래 뇌파 신호용)을 채택
- ❓ dictionary learning: 신호처리/압축 센싱 분야에서 신호를 압축하기 위해 사용. 기본적인 패턴 몇가지를 사전처럼 정해놓고 신호를 그 패턴들의 선형결합으로 근사한다. 그 사전에 있는 단어들(기본패턴)을 atom이라고 보통 말함.
- 최적화 목적식:
-
는 학습된 atom들을 담은 dictionary(각 atom도 하나의 멀티채널 시계열), 가 바로 유저 임베딩(각 atom에 대한 투영 계수). 는 L1 sparsity 강도.
-
기존 matrix factorization 기반 유저 임베딩과의 차이: MF는 유저를 추상적인 latent space에 놓지만, PACE는 임베딩의 각 성분이 “실제 시계열 atom”에 직접 대응되므로 벡터 자체를 시각화/해석할 수 있음
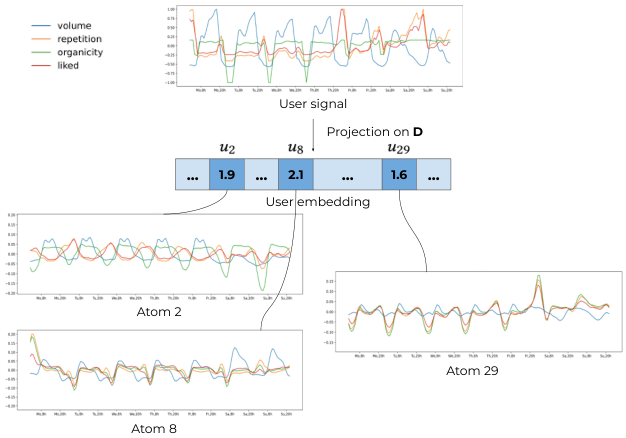
-
한 유저 신호(volume/repetition/organicity/liked 4채널)를 dictionary D에 투영해, atom 2/8/29 등에 대한 계수(예: 1.9, 2.1, 1.6)로 이루어진 유저 임베딩을 만드는 과정을 도식화.
-
- 정규화(-1~1 범위)를 거쳤기 때문에 학습된 atom들은 유저 간 전반적 성향 차이보다 유저 내부(intra-user) 변동 패턴을 더 강하게 포착하도록 의도됨
- -> L2 정규화 대신 min-max 스타일 정규화를 쓴 이유 - “누가 더 많이 듣는가”보다 “언제/어떻게 듣는가의 형태”를 담겠다는 설계 의도
- 가 크면 특정 atom이 특정 유저 신호 재구성에 전문화되는 경향이 생김 (sparsity가 “atom의 특수화”를 유도).
- 실험에서는 atom 개수를 32개로 고정: 다양한 행동을 포괄하면서도 분석 가능한 수준을 유지하기 위한 practical한 선택이라고 밝힘
- reconstruction score, atom 해석가능성, downstream task 성능 간 trade-off가 있다고 언급
Experiments
Dataset & Task 구성
- 데이터: Deezer 유저 대상 RECORDS 프로젝트 설문. “청취 중 어떤 맥락/활동을 함께 하는가”에 대한 복수 응답(wake up, transport, work, sports, friends, asleep 6개 활동으로 한정).
- 약 10k명 응답 중 비활성 유저(일 평균 6스트림 미만, 패턴 탐지가 어려움)를 제외해 7k명으로 축소.
- wake up(18%), asleep(15%)는 비교적 희소한 활동, 나머지(transport 38%, work 39%, sports 50%, friends 47%)는 1/3~1/2 수준으로 흔한 활동.
- -> 즉 이 라벨은 유저당 1개가 나오는 라벨. 실험 자체가 각 세션에서 유저의 행동을 맞히는 것이 아니라 유저가 전반적으로 어떤 유저인지를 맞히는 과제라는 뜻.
- 평가 태스크: 활동별 binary classification 6개 (logistic regression + 5-fold GridSearchCV, ROC AUC, test 33%).
- PACE 임베딩(a)과, 여기에 Gender&Age를 concat한 버전(b)을 평가.
- 베이스라인: (1) Total Volume(1차원), (2) Gender&Age(2차원), (3) Other Activities(예측 대상을 제외한 나머지 5개 활동 응답 벡터, 5차원).
Classification 결과
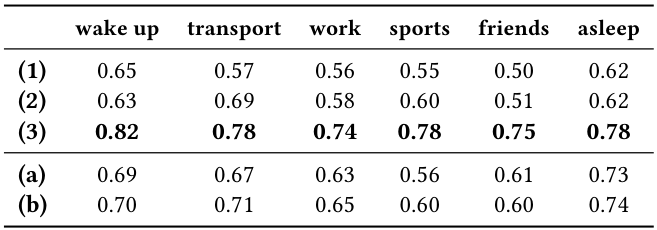
- 6개 활동(wake up/transport/work/sports/friends/asleep)에 대한 ROC AUC 테스트 점수. 행은 (1)Total Volume, (2)Gender&Age, (3)Other Activities, (a)PACE 단독, (b)PACE+Gender&Age.
- 핵심 메시지: (3) Other Activities가 전 라벨에서 가장 강함(0.8 정도, 라벨 간 동질적 유저군이라는 confounding 때문). (1)(2) 베이스라인은 0.6 근처로 약함. PACE(a)는 그 사이에 위치해, 단순 볼륨/인구통계보다는 활동 관련 정보를 더 많이 담고 있음을 보여줌
- 라벨별 편차가 베이스라인보다 PACE에서 더 크게 나타남: 가장 약한 라벨은 sports(0.56)로, PACE가 “규칙성”에 기반한 모델이기 때문에 스포츠처럼 상대적으로 덜 규칙적인 활동은 포착이 어렵다고 해석. 반대로 asleep(0.73~0.74)처럼 거의 매일 반복되는 활동은 상대적으로 잘 맞힘
- (b)처럼 Gender&Age를 결합하면 대부분 라벨에서 성능이 오르고, 특히 transport(0.67→0.71), work(0.63→0.65)에서 향상 폭이 크다. 통근 근로자층이라는 사회인구학적 속성과 청취 패턴이 상호보완적이라는 해석.
Model Interpretation
-
왜 필요한가: 단순히 예측 성능만 보는 게 아니라, 학습된 atom이 실제로 “사람들이 아는 생활 패턴”과 대응되는지를 확인해 임베딩의 해석가능성을 검증하는 단계.
-
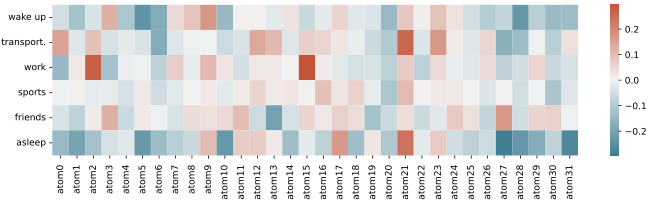
logistic regression 계수의 부호/크기로 각 atom이 특정 라벨에 양/음으로 기여하는 정도를 읽는다.
-
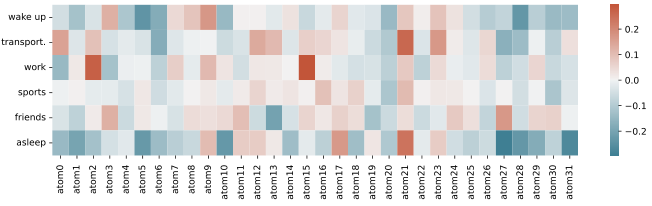
32개 atom × 6개 라벨의 로지스틱 회귀 계수 히트맵.
-
라벨별로 소수의 atom에서 강한 양의 계수가 몰려있는 패턴(예: atom 0=transport, atom 2=work, atom 27=friends)이 관찰되고, 이는 atom들이 라벨과 narrow하게 대응될 수 있음을 시사.
-
atom 0, 2, 27의 4채널(volume/repetition/organicity/liked) 시계열을 주간 스케일로 시각화.
-
atom 0: 평일 아침/저녁 volume 피크 → 출퇴근 청취와 일치.
-
atom 2: 평일 근무시간대에 집중 + 작은 아침/저녁 피크(통근과 중첩), organicity 채널이 근무 중엔 높고(organic 위주) 주말 저녁엔 낮음(algorithmic 위주) → 평일 근무 중엔 능동적 선택, 주말 밤엔 추천 의존적인 파티 맥락이라는 해석.
-
atom 27: volume이 주말, 특히 금/토 저녁에 급증 → 친구 모임·파티 시간대와 일치.
-
-
저자들은 이 해석을 Deezer 내부의 활동별(파티, 업무, 운동) 큐레이션 플레이리스트 데이터와 대조해 시간대 일치를 추가로 확인했다고 언급
-
실제 추천에 쓰이려면 결국 각 시간대 context가 주어졌을 때 그거에 가장 잘 맞는 atom 패턴을 다시 뽑아낸다든지 하는 과정이 필요할 듯