Sparse-Interest Network for Sequential Recommendation (2021)
대규모 아이템 카테고리 풀에서 유저마다 희소한 개념 집합을 adaptively 선택해 다중 관심 임베딩을 만들고, 이를 능동적으로 예측한 현재 의도로 aggregation하는 시퀀셜 추천 모델
- 10억 스케일 산업 데이터(ULarge)에서 2등 베이스라인(MIND) 대비 HR@50 기준 +34.06% 개선.
- inference 시 라벨이 없어도 “다음 의도”를 능동적으로 예측하는 aggregation module로 MIND류의 train/test gap 문제를 완화 + 수백개 이내 군집을 다루는 MIND류 대비 industry 규모의 카테고리 체계에 대응할 수 있음
Background
- 문제의식: 왜 이 논문이 필요한가
-
기존 sequential recommendation(GRU4Rec, Caser, SASRec)은 유저 행동 시퀀스를 하나의 embedding vector로 압축한다 → 최근 빈번한 행동에 지배당한다
-
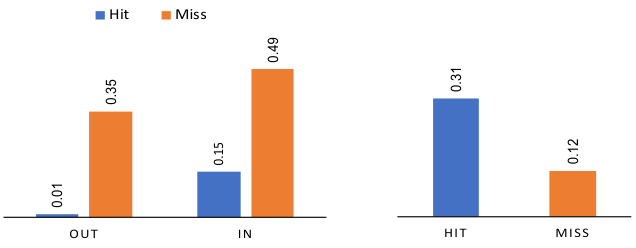
Taobao SASRec 분석: 최근 50개 행동에 next item과 같은 카테고리 아이템이 있을 때(“In”) hit 확률 0.49, 없을 때(“Out”) hit 확률 0.01로 극단적 차이 → 단일 벡터가 최근 지배적 패턴에만 반응함을 실증 (덜 최근이지만 여전히 유효한 관심사를 놓치게 됨)
-
해결책 방향: 유저를 여러 embedding vector로 표현(multi-interest). 그러나 기존 explicit 방식(MCPRN, DisenRec)은 interest 개수 = concept 개수라 concept을 수십~수백 개로 제한해야 한다 → 실제 이커머스는 leaf category가 1만 개 이상(Tmall 기준)이라 scale이 맞지 않음
-
implicit 방식(MIND의 capsule network, SASRec의 multi-head attention)은 concept을 명시하지 않고 내부적으로 분리한다 → 실험적으로 Transformer의 multi-head 표현이 single-head 대비 뚜렷한 이점이 없다고 보고된 바 있음(SASRec 논문)
-
헷갈린 부분이 여기서 explicit, implicit의 의미: implicit은 각 interest가 어떤 prototype에 해당하는지에 대한 명시적 대응점이 없고 그냥 네트워크 표현력에 맡겨서 암묵적으로 분리되는 것
-
- 핵심 과제 3가지
- 아이템은 현실에서 깔끔하게 개념적으로 군집화되어 있지 않다 (카테고리 라벨이 없거나 노이즈가 있다)
- 큰 concept pool에서 유저별로 sparse한 부분집합을 선택하는 discrete selection을 end-to-end로 학습 가능하게 만들어야 한다
- 여러 interest embedding 중 inference 시 어떤 것을 쓸지 결정해야 하는데, next item 라벨은 train에만 있고 test에는 없다
Method
SINE은 크게 sparse-interest extraction module과 interest aggregation module 두 단계로 구성된다.
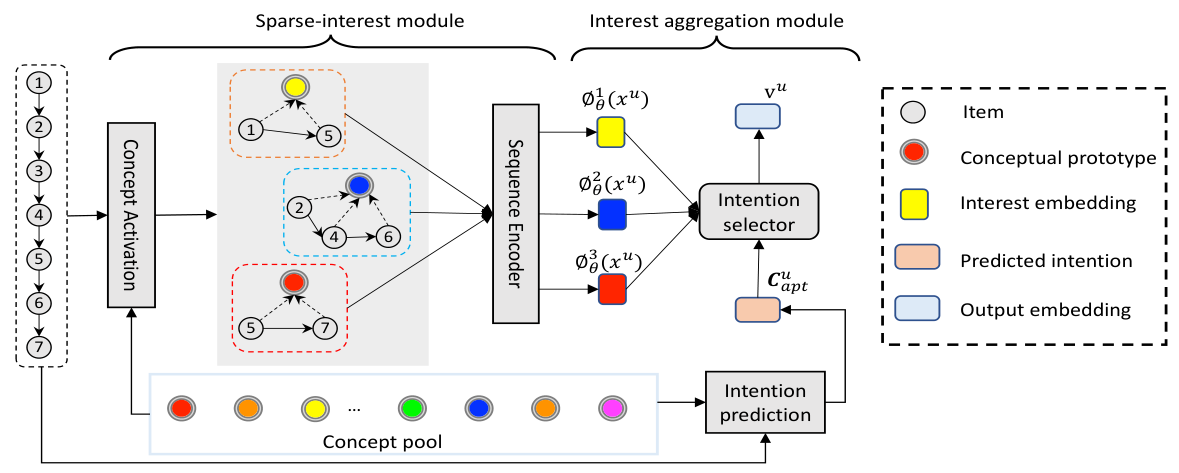
- SINE 전체 아키텍처: concept pool → concept activation → sequence encoder(다중 interest embedding 생성) → intention selector(interest aggregation)로 이어지는 파이프라인
- “큰 concept pool에서 일부만 선택”과 “여러 interest 중 현재 의도를 능동적으로 예측해 집계”라는 두 핵심 아이디어를 한 그림에 압축
Sparse-interest extraction module
각 단계가 왜 필요한지 먼저 요약하면: 유저마다 다른 소수의 concept을 뽑아내고(selection), 시퀀스 내 각 아이템이 어떤 concept/의도에 속하는지 추정한 뒤(assignment), 그 의도별로 시퀀스를 가중합해 interest embedding을 만든다.
- Concept activation (큰 concept pool 중 유저별 Top-K 개념 선택)
- self-attentive pooling으로 시퀀스 전체를 요약하는 “virtual concept vector”를 생성한다:
- 는 유저 의 시퀀스 아이템 임베딩 행렬, 는 유저의 전반적 의도를 요약한 벡터다
- 와 전체 concept pool (은 전체 concept 수, 최대 수천)의 내적으로 관련도 점수를 구하고 top-K만 선택한다:
- 가 유저별로 활성화된 K개 concept 임베딩이다. top-K ranking은 discrete하지만, 선택된 concept에 sigmoid 가중치를 곱해 gradient가 흐르도록 하는 relaxation trick(Graph U-Nets의 기법을 차용)
- -> 즉 이 말은, “선택(discrete)“과 “가중치 부여(continuous)“를 분리해서, 선택 자체는 forward에서 top-K로 하되 backward는 sigmoid gate를 통해 학습 가능하게 만든다는 것
- self-attentive pooling으로 시퀀스 전체를 요약하는 “virtual concept vector”를 생성한다:
- Intention assignment: 시퀀스의 각 아이템이 선택된 K개 concept 중 어디에 속하는지 cosine 유사도 기반 softmax로 추정한다
- inner product 대신 LayerNorm 후 cosine 유사도를 쓰는 이유: dot product는 일부 concept만 계속 선택되는 model collapse에 더 취약하기 때문이다(DisenRec의 관찰을 인용)
- Attention weighting: concept 관점이 아니라, “이 아이템이 다음 의도를 예측하는 데 얼마나 중요한가”를 별도의 self-attention()으로 계산한다. concept마다 독립적인 attention layer를 두고, 여기에는 positional embedding을 더해 순서 정보를 반영한다
- Interest embedding 생성: 두 가중치를 곱해 시퀀스를 집계한다
- 개의 interest embedding 가 최종 산출물이다
-> concept pool 크기 을 top-K selection으로 다루는 방식이 결국 “학습 가능한 soft clustering + hard gating”인데, differentiable top-K trick(sigmoid gating)이 실제로 gradient를 얼마나 풍부하게 흘려보내는지 궁금함. 선택되지 않은 concept은 매 스텝 gradient를 거의 못 받을 텐데
Interest aggregation module
- 왜 필요한가: MIND처럼 train 시 next item을 라벨로 써서 어떤 interest를 활성화할지 고르면(label-aware attention), inference에는 next item 라벨이 없어 train/test gap이 생긴다. SINE은 “다음 의도 자체를 예측”하는 방식으로 이 gap을 없앤다
- intention assignment 로 얻은 분포로 시퀀스를 의도 공간으로 재구성한다:
- 재구성된 시퀀스에 self-attentive pooling을 한 번 더 적용해 “다음 의도” 를 예측한다:
- 예측된 다음 의도와 각 interest embedding의 유사도를 temperature 로 softmax해 집계 가중치를 계산한다:
- 면 사실상 one-hot(가장 맞는 interest 하나만 선택), 면 균등 평균이 된다. 실험에서는 로 거의 hard selection에 가깝게 사용한다 -> 결국 “다음 아이템이 어떤 concept에서 나올지”를 라벨 없이 스스로 예측하게 만드는 구조
Model optimization
- next item 예측을 negative log-likelihood로 학습하되 분모의 전체 아이템 합을 Sampled Softmax로 근사한다(아이템 수가 수백만~수십억이라 full softmax가 불가능하기 때문)
- 추가로 concept prototype들이 서로 겹치지 않도록(=concept pool을 고르게 활용하도록) covariance regularizer를 적용한다:
- 은 prototype 임베딩들의 covariance 행렬이다. off-diagonal(서로 다른 prototype 간 상관)을 억제해 prototype들이 서로 orthogonal하게, 즉 concept pool 전체를 고르게 쓰도록 유도한다. 이게 없으면 모델이 소수 prototype만 반복 사용하는 collapse가 생길 수 있다
Experiments
- 데이터셋: MovieLens, Amazon(Book, rating-only라 5-core 버전보다 sparse), Taobao, 그리고 자체 산업 데이터 ULarge(유저 1억+, 아이템 2500만, interaction 40억 — 논문 중 가장 큰 스케일)
- 비교 대상: 단일 임베딩(GRU4Rec, Caser) vs 다중 임베딩(SASRec, MIND, MCPRN) vs SINE
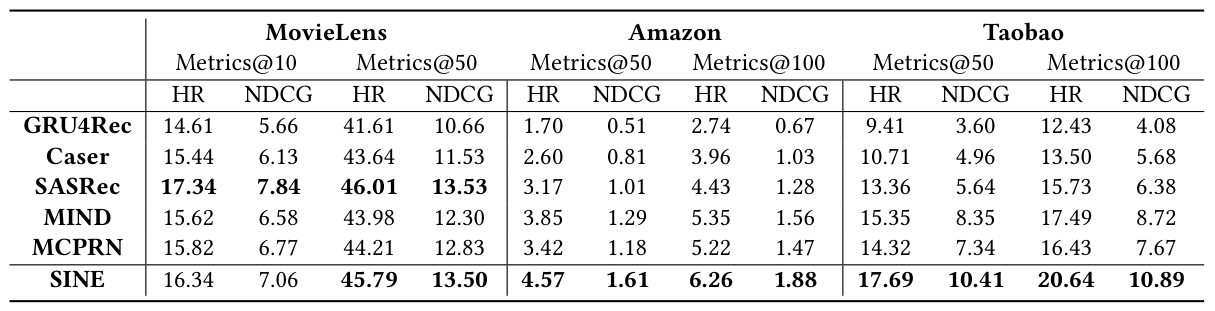
- MovieLens/Amazon/Taobao 3개 공개 데이터셋에서 HR·NDCG@{10,50,100} 비교
- SINE이 Amazon·Taobao에서 전 지표 1위(예: Taobao HR@100 20.64 vs MIND 17.49, SASRec 15.73). MovieLens에서는 SASRec이 더 우세 → 관심사가 다양한 쇼핑 도메인일수록 multi-interest의 이득이 크고, 영화 평점 같은 카테고리가 적은 도메인에서는 이점이 작다는 해석
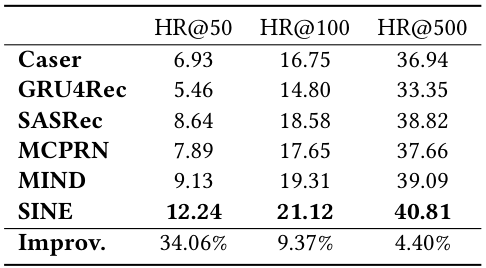
- 10억 스케일 산업 데이터 ULarge에서 HR@{50,100,500} 비교, Improv. 행은 2등 베이스라인(MIND) 대비 개선율
- HR@50에서 SINE 12.24 vs MIND 9.13(+34.06%), HR@500에서는 40.81 vs 39.09(+4.40%)로 격차가 줄어든다 → recall 개수가 늘어날수록 두 모델의 차이가 좁혀지지만, SINE은 적은 후보 수에서도 선호 아이템을 상위에 더 정확히 올린다는 의미(랭킹 품질의 우위)
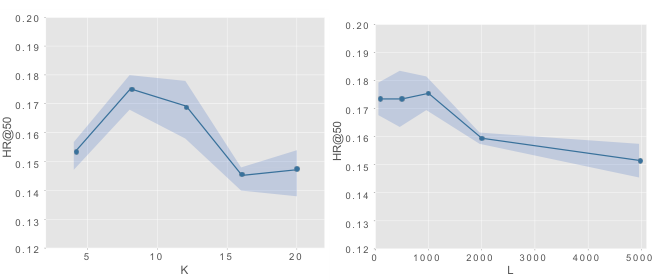
- Taobao에서 intention 개수 ()와 concept pool 크기 ()에 대한 HR@50 민감도
- , 근방에서 최고 성능. Taobao의 실제 카테고리 수가 약 9000개인 것과 비교하면, 학습된 concept이 개별 leaf category보다 더 coarse한 “가상 카테고리” 역할을 한다는 근거
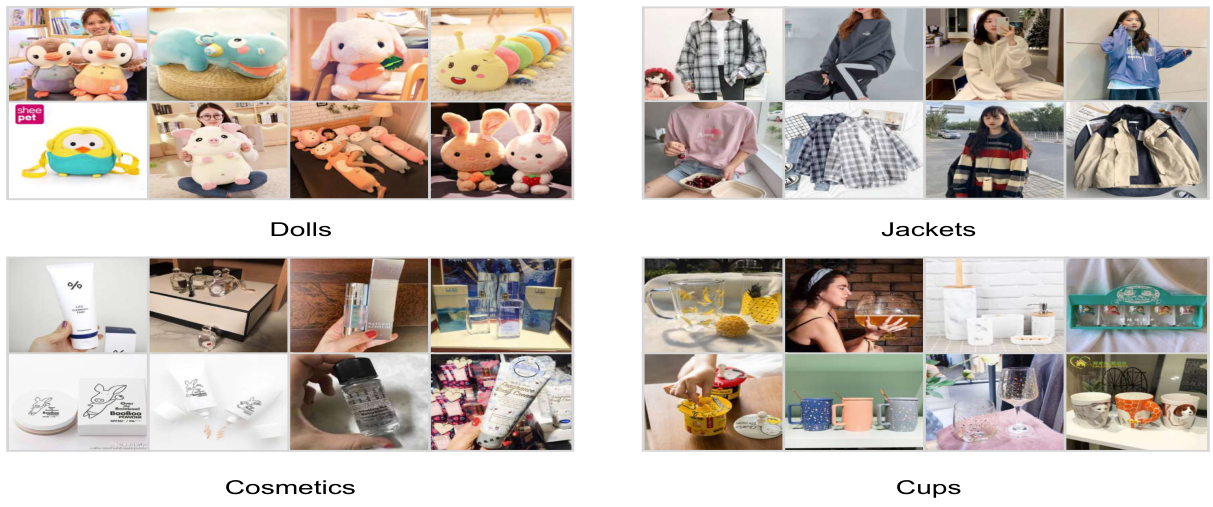
- 학습된 concept prototype 4개(“dolls”, “jackets”, “cosmetics”, “cups”)를 cosine 유사도 기준 top-8 근접 아이템으로 시각화
- 같은 concept 안에 서로 다른 leaf category의 아이템들이 섞여 있다(예: cosmetics concept에 다양한 skin-care 제품) → concept이 leaf category보다 상위의 semantic intention을 포착한다는 정성적 증거
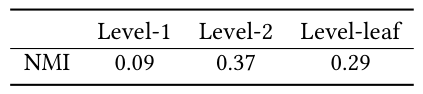
- 산업 카테고리 체계(1차/2차/leaf 레벨)와 학습된 concept 간 clustering 품질을 NMI로 비교(1차 178개, 2차 7,945개, leaf 14,874개 카테고리 기준)
- 2차 레벨과 NMI 0.37로 가장 높다(1차 0.09, leaf 0.29) → 학습된 concept이 지나치게 coarse(1차)하지도, 지나치게 fine-grained(leaf)하지도 않은 중간 수준의 semantic을 포착
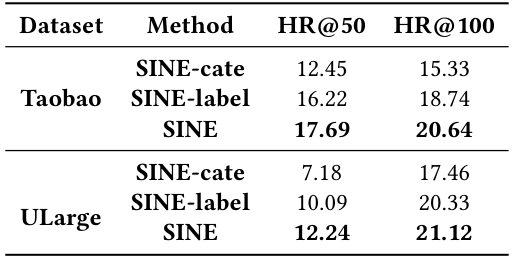
- ablation: SINE-cate(카테고리 속성을 prototype으로 그대로 사용) vs SINE-label(MIND처럼 label-aware attention으로 집계) vs SINE
- Taobao HR@100 기준 SINE-cate 15.33 < SINE-label 18.74 < SINE 20.64
- SINE vs SINE-cate 격차: “학습된 concept”이 “주어진 카테고리”보다 아이템을 더 잘 군집화한다는 것을 입증(joint clustering의 가치)
- SINE-cate에서 쓴 건 leaf카테고리에 가까워서(매우 세밀한 레벨) 너무 잘게 쪼개져 있다 - 사실 메타 카테고리에 더 한단계 높은 카테고리가 있긴 할 텐데; 근데 NMI보면 SINE이 학습한 컨셉은 또 그 상위 레벨이랑도 엄청 똑같진 않은가봄
- SINE vs SINE-label 격차: interest aggregation module(능동적 의도 예측)이 label-aware attention보다 낫다는 것을 입증(train/test gap 해소의 가치)